Los tokens ponderados, explicados: elige el plan adecuado y haz que dure
Cómo mide apmix el uso de todos los modelos con una sola cuota, cómo convertir un plan en tokens reales en cualquier modelo y formas prácticas de estirar la cuota de cada mes.
 El equipo de apmixPublicado 4 min de lectura
En esta página
Cada modelo tiene un precio distinto. Un token de un modelo rápido cuesta una fracción de uno de un modelo de frontera, y los modos de razonamiento cuestan todavía más. La mayoría de las pasarelas lo resuelven con una lista de precios por modelo y una factura que solo entiendes a fin de mes. apmix usa en cambio una única unidad para todo: el token ponderado.
Una unidad para todos los modelos
Tu plan es un presupuesto mensual de tokens ponderados, compartido por todos los modelos del plan y todas las claves de tu cuenta. Cada modelo tiene un multiplicador: cuántos tokens ponderados cuesta un token real en ese modelo.
- En un modelo 1×, un token real cuesta un token ponderado.
- En un modelo 3×, el mismo token cuesta tres.
- Se cuentan tanto los tokens de entrada como los de salida, incluidos los de razonamiento, y luego se multiplican por la tarifa del modelo.
Así, un intercambio de 1.000 tokens cuesta 1.000 tokens ponderados en un modelo 1× y 3.000 en uno 3×. Los multiplicadores se fijan por modelo; la página de precios, la página de cada modelo y tu panel muestran siempre el valor actual.
Convierte un plan en tokens reales
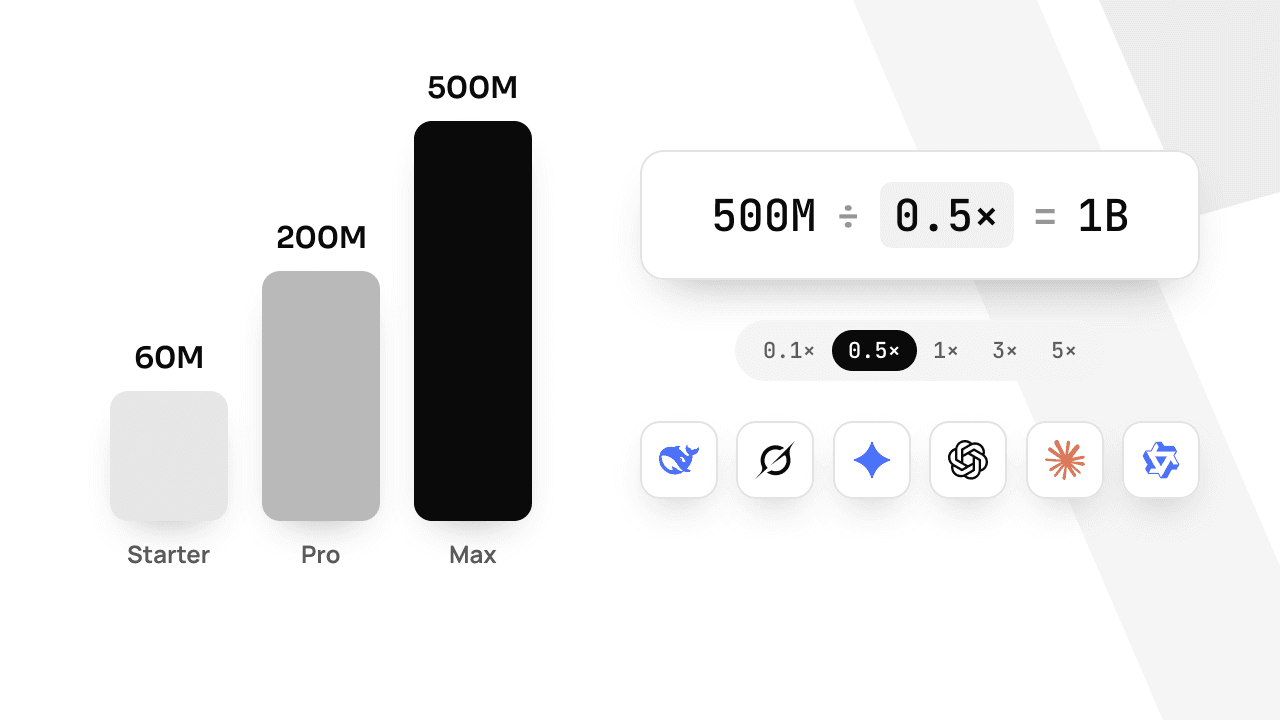
La pregunta útil no es «cuántos tokens ponderados tengo», sino «cuánto puedo enviar de verdad al modelo que uso». La respuesta es una división:
Tokens reales al mes = cuota del plan ÷ multiplicador del modelo
Esto es lo que compra la cuota mensual de cada plan con algunos multiplicadores:
En el momento de escribir esto, algunos modelos rápidos cuestan incluso menos de 1×: a 0,5×, los 60M de Starter compran 120M de tokens reales, y a 0,1×, 600M.
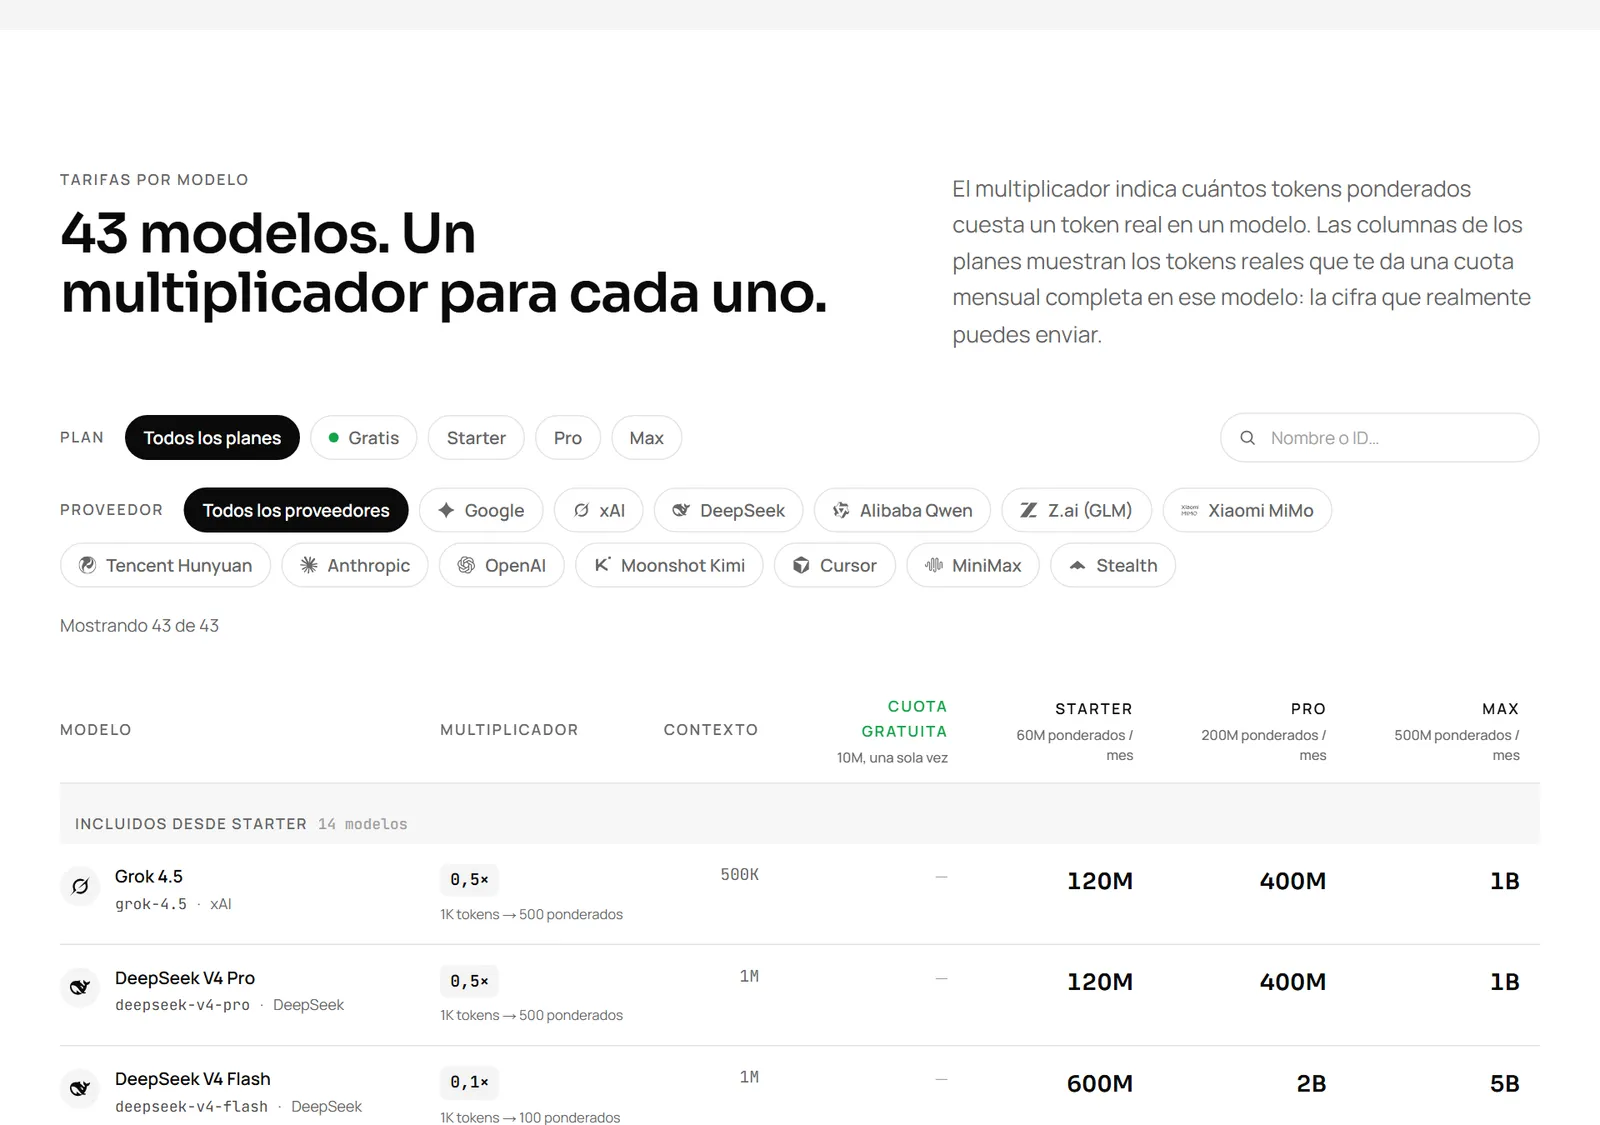
La página de precios hace este cálculo para cada modelo del catálogo, así que puedes comprobar la cifra exacta de los modelos que usas antes de elegir un plan.
¿Qué plan te conviene?
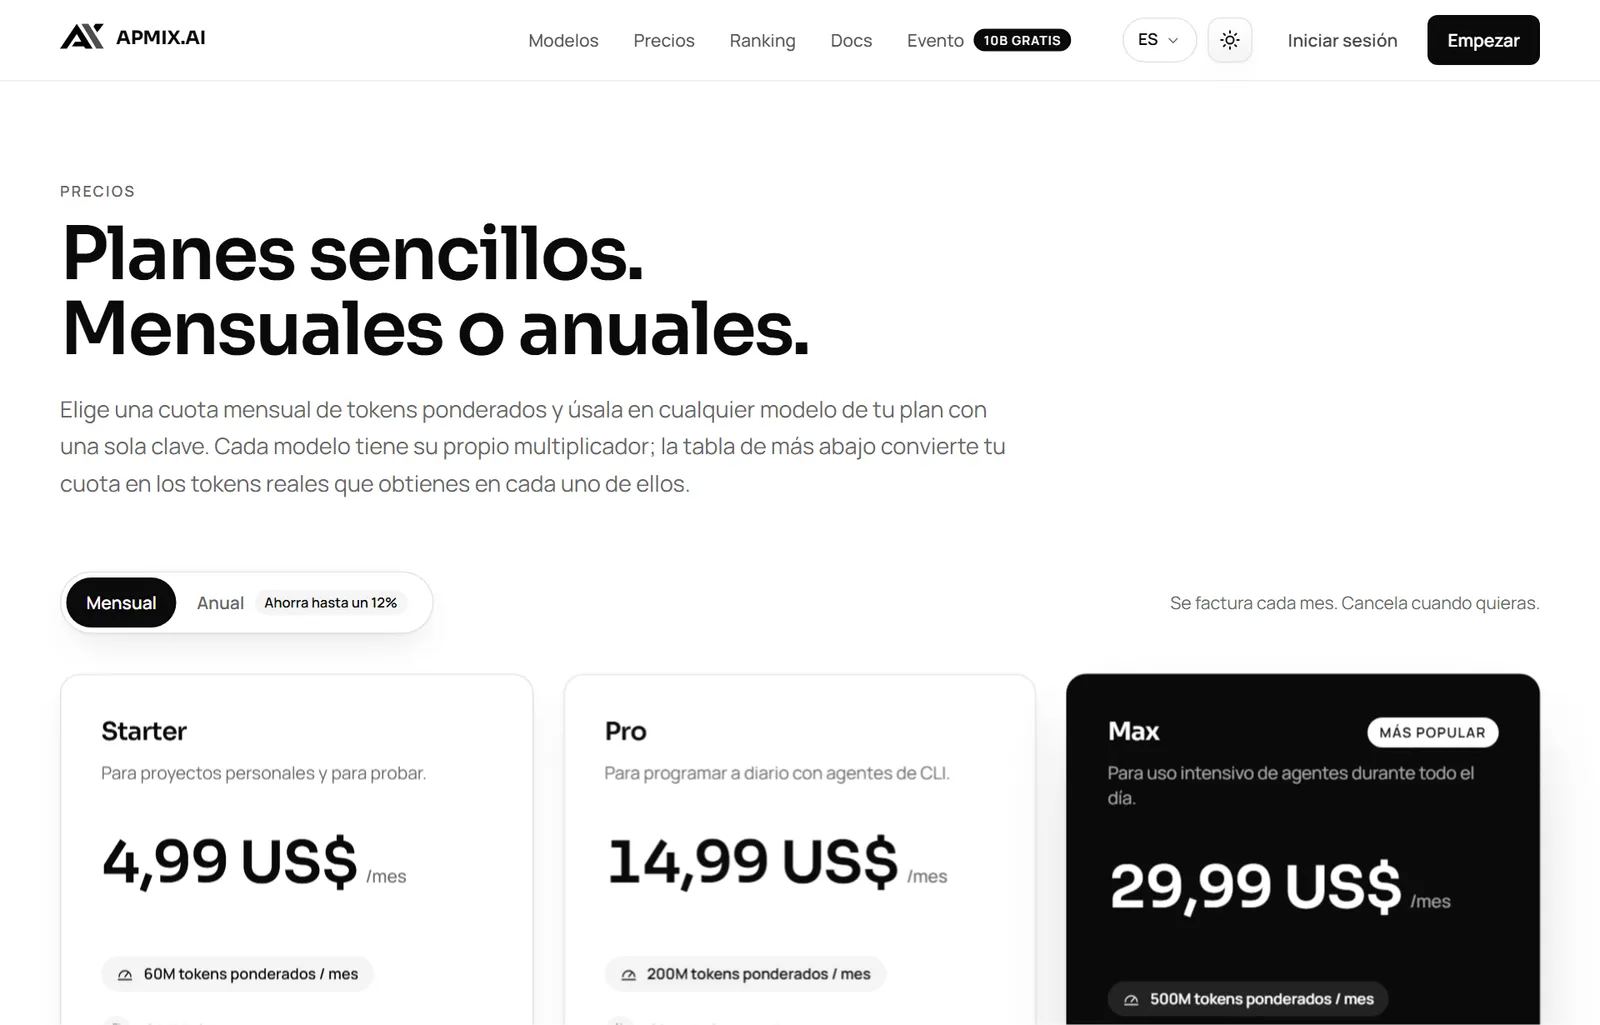
- Starter ($4.99 al mes, 60M) encaja con proyectos personales, evaluaciones y sesiones de agente ocasionales, sobre todo con modelos rápidos.
- Pro ($14.99 al mes, 200M) está pensado para programar a diario con agentes de terminal como Claude Code o Codex, y añade más modelos.
- Max ($29.99 al mes, 500M) es para cargas de agentes intensas durante todo el día. Cubre el catálogo completo, permite claves ilimitadas y tiene enrutamiento prioritario.
Los planes son escalonados: un plan superior incluye todos los modelos de los planes inferiores. La facturación anual da la misma cuota mensual durante doce meses a un precio más bajo, en un solo pago.
Haz que la cuota dure
Unos pocos hábitos marcan una gran diferencia, sobre todo con agentes que envían contextos largos:
- Elige el modelo según la tarea. Usa un modelo rápido y de multiplicador bajo para cambios rutinarios, pruebas y refactorizaciones pequeñas, y pasa a un modelo de frontera para las partes difíciles. La misma cuota rinde de tres a cinco veces más en un modelo 1× que en uno 3× o 5×.
- Usa los modos de razonamiento con intención. Cuentan con tarifas más altas. Actívalos para la arquitectura y los errores complicados, no para renombrar variables.
- Mantén las sesiones del agente centradas. En cada turno se vuelve a enviar la conversación. Empezar una sesión nueva para una tarea nueva es más barato que arrastrar un contexto enorme.
- Mira los registros en vivo. Panel → Registros muestra cada solicitud con su modelo, sus tokens y su coste ponderado en el momento.
- Pon tus propios límites. Los topes diarios y semanales opcionales en Ajustes detienen un bucle descontrolado, y los avisos por correo al 50, 70, 80 o 90 % te dicen cómo vas.
Los desarrolladores también pueden leer el contador desde el código. Cada respuesta incluye x-apmix-weighted-tokens, lo que costó esa solicitud, y x-apmix-remaining, lo que queda del mes.
Cuando un mes se queda corto
Si agotas la cuota, las solicitudes devuelven un error claro allowance_exhausted hasta el reinicio mensual. Tienes dos formas de seguir al instante:
- Mejorar el plan. Se aplica de inmediato y la diferencia se cobra de forma prorrateada.
- Comprar una recarga. Paquetes únicos de 10M, 30M, 60M o 100M tokens ponderados; el de 10M cuesta desde $1.49 en Max, $1.79 en Pro y $1.99 en Starter. Las recargas se consumen después de la cuota mensual y nunca caducan mientras tengas un plan.
Facturación justa
Los planes mensuales se reembolsan por completo mientras hayas usado menos del 5 % de la cuota del mes, y las recargas sin usar se pueden reembolsar durante 14 días. Los planes anuales no son reembolsables. La política de reembolso tiene las cifras exactas de cada plan.
¿Todavía lo estás pensando? Las cuentas nuevas reciben tokens gratis en los modelos gratuitos, sin tarjeta, así que puedes ver tu propio uso en tokens ponderados antes de elegir un plan. Crea una cuenta y mira el contador después de tu primera sesión.